
Vous avez passé des semaines sur le terrain, piégé, trié, identifié. Votre inventaire compte 84 espèces. Une question se pose alors : est-ce l’ensemble de la communauté, ou seulement la partie visible ? C’est à cette question que répond SpadeR, un outil en ligne gratuit qui estime la diversité réelle d’un site à partir de ce que vous avez effectivement récolté.
Le problème : un inventaire n’est jamais complet
Quel que soit l’effort d’échantillonnage, des espèces rares peuvent toujours passer à travers les mailles du filet. Une espèce représentée par un seul individu a pu être attrapée par chance ; d’autres, tout aussi présentes, n’ont simplement pas été vues. Compter les espèces observées donne donc une valeur minimale de la richesse spécifique, jamais la richesse spécifique réelle. Or cette différence compte : comparer deux sites, évaluer un effort d’échantillonnage, suivre un habitat dans le temps ou justifier une mesure de gestion exigent de savoir si l’on compare des inventaires complets ou des inventaires incomplets à des degrés différents.
L’idée clé : les espèces rares racontent ce qui manque
Si votre dans votre échantillon, le nombre d’espèces observées une seule fois, aussi appelé les « singletons » est important, c’est que de nombreuses espèces ont failli vous échapper, et donc que d’autres ont probablement échappé complètement. À l’inverse, si presque toutes vos espèces sont représentées par plusieurs individus, votre inventaire est probablement proche de l’exhaustivité. C’est sur ce principe que reposent les estimateurs de richesse proposés par SpadeR (Chao1, ACE, jackknife…). SpadeR a été développé autour des travaux d’Anne Chao et de ses collègues en 2015 (Chao et al., 2015).
Préparer ses données : plus simple qu’il n’y paraît
Aucune connaissance de R n’est nécessaire. SpadeR fonctionne dans le navigateur : chao.shinyapps.io/SpadeR.
Dans un tableur, calculez l’effectif total de chaque espèce (un individu compté dans toutes vos sessions de capture, par exemple).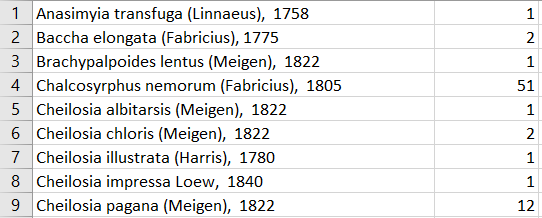
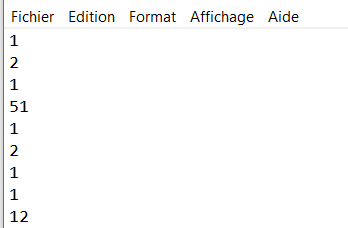
Copiez uniquement la colonne des effectifs dans un fichier texte (.txt, type Bloc-notes), un nombre par ligne. Les noms d’espèces ne servent pas au calcul : seule compte la liste des abondances.
Lancer l’analyse en quatre clics
Dans l’onglet Species :
- Choisissez le type de données Abundance data (données d’abondance).
- Cochez Upload data.
- Cliquez sur Browse et chargez votre fichier .txt.
- Cliquez sur Run!
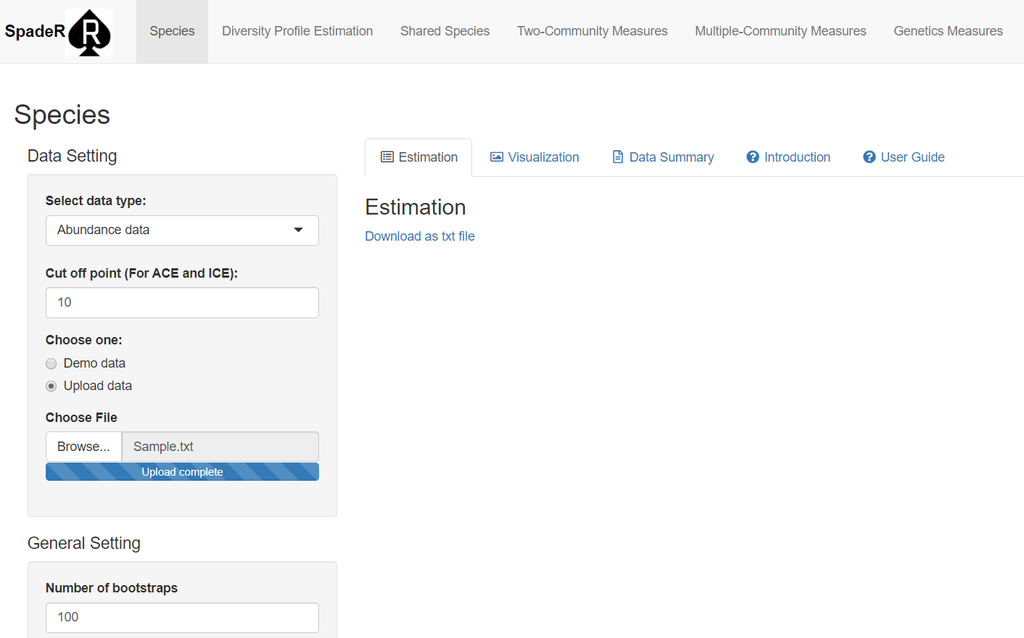
Deux réglages par défaut méritent d’être connus : le cut-off point (10), seuil qui sépare les espèces « rares » des espèces « abondantes » pour l’estimateur ACE, et le nombre de bootstraps (100), c’est-à-dire le nombre de rééchantillonnages utilisés pour calculer les marges d’erreur.
Lire les résultats : l’exemple d’un inventaire de syrphes
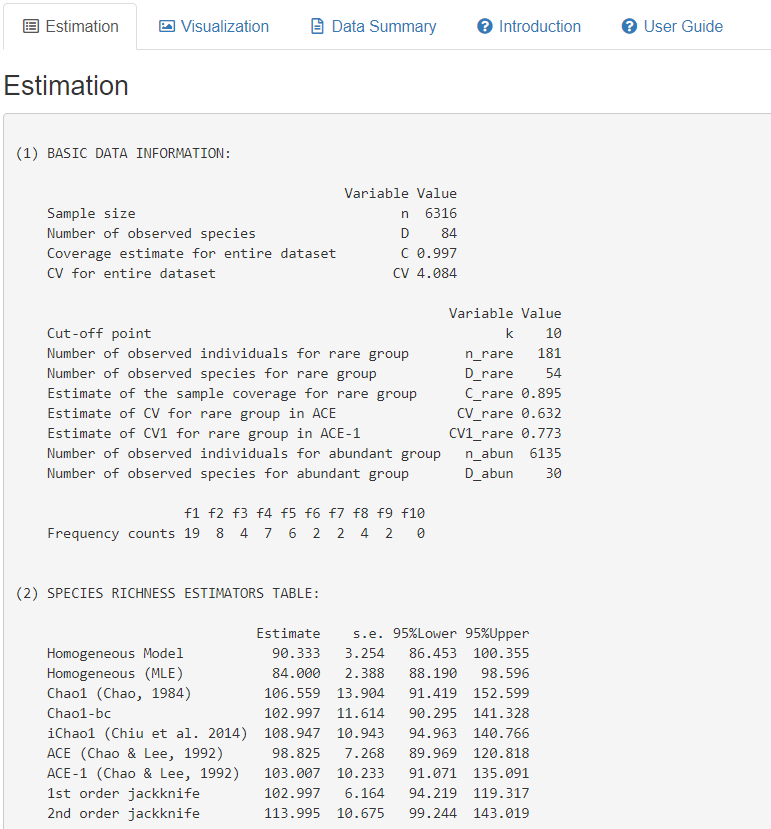
L’exemple utilisé ici porte sur des échantillonnages de syrphes (mouches de la famille des Syrphidae, importantes pour la pollinisation) : 6 316 individus, 84 espèces observées. Dans l’onglet Estimation, trois chiffres se dégagent.
Le taux de couverture :
Attention, ce chiffre est souvent mal interprété. Il ne signifie pas que 99,7 % des espèces ont été trouvées. Il signifie que si l’on capturait un nouvel individu au hasard, il y a 99,7 % de chances qu’il appartienne à une espèce déjà dans votre inventaire. Autrement dit, les espèces manquantes sont très peu abondantes : elles représentent environ 0,3 % des individus.
La richesse estimée :
Avec l’estimateur jackknife d’ordre 1, la richesse totale estimée est de 103 espèces, avec un intervalle de confiance à 95 % de 94 à 119. L’intervalle donne la plage de valeurs plausibles : le vrai chiffre est vraisemblablement quelque part entre 94 et 119.Le principe du jackknife 1 est simple : on part des espèces observées (84) et on ajoute une correction proportionnelle au nombre de singletons. Ici, 19 espèces n’ont été vues qu’une fois, d’où une estimation proche de 84 + 19 = 103.
La complétude d’échantillonnage :
Ce dernier indicateur n’est pas fourni directement par SpadeR, mais se calcule en une ligne : espèces observées ÷ espèces estimées × 100 = 84 ÷ 103 × 100 ≈ 81,5 %
L’inventaire a donc révélé environ quatre espèces sur cinq du peuplement estimé.
Couverture élevée, complétude plus modeste : contradiction ?
Non, et c’est précisément l’intérêt de lire les deux. La couverture mesure la part des individus déjà « connus », tandis que la complétude mesure la part des espèces. Une poignée d’espèces très abondantes (l’une d’elles compte 51 individus, pèse lourd dans la première, alors que de nombreuses espèces rares, peu visibles, pèsent davantage dans la seconde. Un inventaire peut donc être excellent pour décrire les espèces dominantes et rester lacunaire pour les espèces discrètes.
À quoi ça sert concrètement ?
- Évaluer son effort d’échantillonnage : faut-il retourner sur le terrain, ou l’inventaire est-il suffisant ?
- Comparer des sites ou des années sur des bases équitables, malgré des efforts d’échantillonnage différents.
- Justifier une méthodologie dans un rapport d’étude, un mémoire ou un article, avec des chiffres et des marges d’erreur.
- Prioriser la conservation : estimer combien d’espèces restent à découvrir aide à juger de la richesse d’un milieu.
Limites et précautions :
- Il n’existe pas un seul estimateur. Le tableau de résultats en propose plusieurs (Chao1, ACE, jackknife d’ordres 1 et 2…) qui donnent des valeurs différentes : dans l’exemple, de 98,8 à 114. Il convient de choisir l’estimateur selon la nature des données, de justifier ce choix et de le conserver pour toutes les comparaisons.
- Les estimateurs sont prudents. Ils partent de ce qui a été observé et ne peuvent pas « deviner » des espèces très rares qui n’ont laissé aucune trace dans l’échantillon.
- La qualité des données prime. Une identification incertaine ou un effort de capture très hétérogène fausseront le résultat.
- Un échantillon trop petit donne des intervalles de confiance très larges, donc peu informatifs.
À retenir :
- Un inventaire donne un minimum, pas la diversité réelle.
- SpadeR estime ce qui manque à partir de la fréquence des espèces rares, sans installer R.
- Il faut lire ensemble la couverture (part des individus connus), la richesse estimée avec son intervalle de confiance, et la complétude (part des espèces connues).
Références :
Chao, A., Ma, K. H., Hsieh, T. C. and Chiu, C. H. (2015) Online Program SpadeR (Species-richness Prediction And Diversity Estimation in R). Program and User’s Guide published at http://chao.stat.nthu.edu.tw/wordpress/software_download/. Outil disponible en ligne sur chao.shinyapps.io/SpadeR. Pour aller plus loin, la documentation de l’application (onglet « User Guide ») détaille les estimateurs et leurs hypothèses.


